Patrizia Favaron

La media di un pollo grande e di uno piccolo è... Dilemmi esistenziali statistici!

Appunti di statistica meteorologica: medie e dintorni

Patrizia Favaron Introduzione “Media”. Cosa c’è, di più semplice? Ed infatti è cosa semplice: basta prendere i numeri che ci interessano, sommarli tra loro, e dividere per quanti erano. Basta una calcolatrice. Sino a che i numeri sono, diciamo, una decina. Da dieci a cento, un foglio Excel comincia a non fare schifo. Oltre i cento… 🙄 In questo articolo vedremo come si può calcolare una media-monstre di 263089 misure di velocità del vento (quel numero lì di misure, e non un altro, perché vogliamo calcolare la media complessiva delle velocità mediate su 10 minuti). Quanto ai dati, sono le velocità del vento raccolte dalla stazione meteorologica ARPA Lombardia di Bormio Eliporto nel periodo dal 01. 01. 2020 al 01. 01. 2025, per un totale di 5 anni complessivi: non abbastanza per fare della climatologia, ma più che sufficienti per indicarci qualche domanda e, se possibile, ottenere delle risposte. I dati – intanto Acci. Duecentosessantatremilaottantanove numeri… Mica pochi. E tutti corredati da una “marca temporale”, che indica quando sono stati raccolti. Tempo, più dati, uguale “serie temporale”: una raccolta di misure, più o meno lunga, che in linea di principio ci può permettere di capire qualcosa (se c’è qualcosa da capire) sull’andamento del vento a Bormio. Serie temporali come questa sono oggetti concettualmente diversi dagli insiemi di dati che capita spesso di dover comprendere a colpi di statistica. Per vederlo, consideriamo un insieme di dati più “normale”, come ad esempio le lunghezze dei lingotti di acciaio che arrivano al laminatoio. In teoria queste lunghezze dovrebbero essere tutte esattamente uguali, ma nella realtà tra le misure dell’una e dell’altra qualche differenza c’è sempre – o potrebbe esserci. In questo caso, se desideriamo quantificare la produzione giornaliera di lamiera dovremo conoscere qualcosa delle lunghezze (ed anche altezze, spessori, pesi, presenza o no di bolle e cricche, …) dei lingotti che entrano nel processo. E per farlo, uno dei modi migliori è di calcolare la media aritmetica delle lunghezze (altezze, spessori, pesi, …) e, per ogni lingotto, lo scostamento in più od in meno rispetto alle medie. Così, tanto per farsi un’idea: lingotto piccolo, o grande? Pieno di fratture che magari denotano una qualità del materiale sotto standard? E via così. In un certo senso, però, ogni lingotto è un caso a sé. E tutti sono stati prodotti da uno stesso processo, con effetti sperabilmente identici. Ho detto “lingotti”, ma avrei potuto parlare di risultati di misure di un esperimento di laboratorio, o di tempo passato dalle persone in un supermercato, oppure di prezzo di esemplari diversi di uno stesso bene. O di un’infinità di altre cose. Nel caso, la media ci da un’idea piuttosto precisa di cosa potremmo aspettarci, arrivassero nuovi esemplari dell’oggetto, o della misura. E la media del valore assoluto, o del quadrato, degli scostamenti ci direbbe quanto sono “dispersi” i dati. Ma qui siamo in una situazione molto diversa: ogni dato, etichettato da un tempo, è sì diverso dagli altri, ma in un certo senso di più. In una serie temporale, i valori misurati non sono necessariamente il risultato di misure tra loro indipendenti: nel caso delle velocità del vento, per esempio, se in corrispondenza di una certa marca temporale abbiamo una lettura di, facciamo finta, 10 m/s allora sarebbe piuttosto sorprendente scoprire che il dato immediatamente successivo è di 1 m/s o 50 m/s: è molto più facile che troviamo un valore non troppo distante da 10 m/s. Più facile, certo, e non “sicuro”: comunque, siamo di fronte ad un fenomeno caratterizzato da un certo grado di variabilità interna, ed incertezza, ma anche da una qualche struttura di dipendenza tra un valore e quelli che lo seguono nel tempo. Di più: le serie temporali sono, spesso, la manifestazione visibile di processi fisici ben precisi, che in qualche modo ci interessano. Poi, la natura di questo interesse può essere la più varia: scientifica, oppure economica (che so, quanta energia sarebbe estraibile dal vento se piazzassimo una turbina eolica a fianco della stazione), oppure, perché no, di semplice curiosità personale. Anche questo conta, e lo vedremo: ma viene dopo le misure, ed il processo che si nasconde dietro ad esse. Comunque, il fatto che una serie temporale non sia la stessa cosa di un insieme di misure di laboratorio non vuol dire che sui suoi valori non possiamo determinare la media, ed altri indicatori statistici. Popolazione, e campioni Supponiamo, così, di voler determinare il valor medio di tutte le misure che abbiamo a disposizione. Questo insieme, l’insieme su cui desideriamo compiere qualche affermazione “forte” basata sui dati, sarà la nostra popolazione. I dati li ho scaricati dal sito di ARPA Lombardia e, almeno nominalmente, ci sono tutti. Potrei caricarli dentro Excel, e fare tutto lì. Ma personalmente preferisco usare il programma statistico “R”, che da alcuni vantaggi: Se non lo conosci, ti invito a prenderne visione, e magari scaricarlo dal sito ufficiale e provare a usarlo, con l’aiuto di uno dei tanti bellissimi tutorial che si trovano in rete. Se già non conosci “R” questa esplorazione potrebbe comportare un certo sforzo da parte tua. Ma, assicuro, ne vale la pena. Prima di calcolare medie e quant’altro, però, dobbiamo leggere i dati. In R, disponendo dei dati (che puoi scaricare qui – dopo averli scaricati, per poterli adoperare questi vanno “decompressi”), la lettura ed altre operazioni si fanno usando dei “comandi”, cioè delle righe di testo con le istruzioni per il calcolatore, che una volta scritte si possono fare eseguire premendo il tasto “Invio”. Nel caso, per leggere i dati (che ho sistemato in un file di nome “Vel.csv”) il comando da usare è d <- read.csv(“Vel.csv”) Il senso di questo comando è di leggere i dati in formato CSV ( read(“Vel.csv”) ), e riversare il contenuto nella “variabile” ‘d’. A comando eseguito, ‘d’ conterrà tutti i dati presenti nel file. Una volta che i dati sono finiti in ‘d’, possiamo farci tutto quello che vogliamo. Per esempio, con l’altro comando names(d) farci dire come si chiamano le colonne della

Appunti di statistica meteorologica: medie e dintorni Leggi tutto »

Nuovo assegno di ricerca sulla variabilità oceanica intrinseca nel Mediterraneo

Il Dipartimento di Scienze Ambientali, Informatica e Statistica dell’Università Cà Foscari ha indetto un bando per l’attribuzione di un assegno di ricerca sulla variabilità oceanica intrinseca nel Mediterraneo. Chiunque avesse interesse è invitata/invitato a sottoporre la propria candidatura entro il 10. 02. 2025 come indicato in dettaglio alla URL https://apps.unive.it/common2/file/download/assegni_ricerca/675af514f3e8a. L’assegno avrà durata di 18 mesi con possibilità di rinnovo; l’attività inizierà indicativamente in Febbraio-Marzo 2025. L’attività che il candidato / la candidata condurrà consisterà nella simulazione con mesh fine della dinamica di aree specifiche, con l’obbiettivo di ottenere informazioni sui fenomeni a submesoscala. Tutor e referente scientifico: prof. Angelo Rubino. SSD: GEOS-04/C GSD: 04/GEOS-04.

Nuovo assegno di ricerca sulla variabilità oceanica intrinseca nel Mediterraneo Leggi tutto »

Abstract submission aperta per la International Mountain Conference 2025 (IMC-2025)

Sono finalmente aperte le iscrizioni di abstract per la International Mountain Conference 2025, (IMC-2025) che si terrà ad Innsbruck, dal 14 al 18 Settembre 2025. La deadline per l’invio degli abstract è fissata al 20 Febbraio. La IMC è ad oggi la più importante conferenza sulla ricerca negli ambienti montani. Una sua caratteristica distintiva è il costante incoraggiamento di scambi interdisciplinari, e interazione tra i/le partecipanti. La IMC da particolare rilievo a sintesi che permettano una comprensione olistica del sistema-montagna. La IMC-2025 ospiterà la sessione speciale “Recent advances in the Elevation-Dependent Climate Change in Global Mountains“, I cui dettagli si trovano a questo link, e che certamente risulterà di particolare interesse per “noi AISAM”. Per informazioni, ci si può rivolgere alla casella e-mail della conferenza, support@imc2025.info .

Abstract submission aperta per la International Mountain Conference 2025 (IMC-2025) Leggi tutto »

Evento: presentazione del Polo Documentario Storico Italiano della Sismologia e Meteorologia

Cosa Il progetto, promosso dall’Istituto Nazionale di Geofisica e Vulcanologia e dal Museo Galileo, con la collaborazione di altri prestigiosi Enti nazionali, mira a creare un archivio pubblico che conservi le riproduzioni digitali di registrazioni analogiche e altra documentazione cartacea di valore storico-scientifico nell’ambito della sismologia e della meteorologia. L’archivio valorizzerà il ricco patrimonio italiano in queste due discipline, garantendo l’accesso a dati fondamentali per gli studiosi. L’Italia vanta infatti una lungatradizione in questi campi, ma una parte significativa della documentazione è andata persa o è a rischio di dispersione. Preservare questi dati è essenziale per la ricerca e la comprensione dei fenomeni naturali, anche per le relative ricadute sociali. Il progetto rappresenta un importante passo avanti nella conservazione del patrimonio scientifico italiano, assicurando che le generazioni future possano beneficiare dell’eredità dei pionieri della sismologia e della meteorologia. Quando, e dove Il 27 gennaio 2025, alle ore 17.00, presso la Sala Righini Bonelli del Museo Galileo (Firenze, Piazza dé Giudici, 1) si terrà un evento di presentazione del progetto “Polo Documentario Storico Italiano della Sismologia e Meteorologia“. Relatori Roberto Ferrari – Direttore esecutivo Museo Galileo Carlo Doglioni – Presidente Istituto Nazionale di Geofisica e Vulcanologia Gabriele Tarabusi e Graziano Ferrari – Istituto Nazionale di Geofisica e Vulcanologia Stefano Casati – Museo Galileo Come partecipare La partecipazione è possibile sia in presenza che da remoto. L’ingresso è libero fino a esaurimento dei posti disponibili. L’evento potrà essere seguito anche sui seguenti canali YouTube: youtube.com/@museogalileofirenze (qui il link) e youtube.com/ingveventi (si veda qui).

Evento: presentazione del Polo Documentario Storico Italiano della Sismologia e Meteorologia Leggi tutto »

4th MeteoXchange ECS Conference: la presentazione degli abstract scade tra poco!

Cosa La conferenza 4th MeteoXchange ECS (“Early Career Scientists“), arrivata alla sua quarta edizione, è un’esperienza arricchente per scienziati e scienziate nel campo delle Scienze dell’Atmosfera (e discipline correlate) all’inizio delle loro carriere: un’occasione per studenti e studentesse, e laureati/e dei corsi di laurea triennale, magistrale e di dottorato per presentare la propria ricerca, migliorare le proprie capacità di esposizione e collegarsi con altri giovani scienziati in un ambiente amichevole. Non ci sono sessioni specifiche: tutti i temi legati alle Scienze dell’Atmosfera sono egualmente benvenuti! Il programma finale verrà deciso sulla base dei fusi orari delle persone registrate. È prevista la consegna di un premio per la miglior presentazione orale, e per il miglior poster. Quando Il termine di presentazione degli abstract per la quarta edizione della Conferenza MeteoXchange ECS si avvicina: c’è tempo sino al 31 Gennaio 2025. La conferenza, erogata in modalità online, si terrà nei giorni 10 e 11 Aprile 2025, ed includerà seminari, presentazioni orali, una sessione poster, ed eventi sociali. La partecipazione è gratuita, previa registrazione al sito https://www.meteoxchange.de/meteomeet/4th-meteoxchange-conference-2025/; le registrazioni si chiuderanno il giorno 28 Marzo 2025. Per maggiori informazioni, si prega di fare riferimento al link indicato sopra.

4th MeteoXchange ECS Conference: la presentazione degli abstract scade tra poco! Leggi tutto »

L’insostenibile leggerezza del ricircolo

Patrizia Favaron Il ricircolo: quando l’atmosfera diventa un boomerang Tutti e tutte siamo a conoscenza del fatto che ogni giorno le stazioni meteorologiche sparse nel Mondo raccolgono tonnellate di dati, tra i quali velocità e direzione di provenienza del vento orizzontale. E quando pensiamo al vento, ce lo immaginiamo giustamente come un vettore nel piano: giustamente, mi verrebbe da dire, dal momento che il vento _è_ il vettore-velocità del flusso d’aria nel punto in cui viene misurato. I vettori, lo sappiamo, si possono misurare – usando la Regola del Parallelogrammo. Se vogliamo possiamo esprimerla in termini numerici: se V1 = (vx1, vy1) è il vento all’istante 1, e V2 = (vx2, vy2) quello all’istante 2, la loro somma è Vtotale = (vx1 + vx2, vy1 + vy2) Facile, no? Cosa sono queste “vx1”, “vx2”, “vy1”, “vy2”? Facile anche questo: sono le componenti cartesiane del vento agli istanti 1 e 2, e con una briciola di trigonometria ne possiamo calcolare il valore: vx1 = -Velocità1 * sin(Direzione1) vy1 = -Velocità1 * cos(Direzione1) e via così. Il segno “-“, perché ci interessa sapere verso dove va il vento, e non da dove viene; quanto al seno ed al coseno, che sembrano “sbagliati”, è perché gli angoli della direzione si contano a partire da Nord in verso orario, invece che da Est in verso antiorario come si fa in geometria. Ma va be’, è una definizione come tutte le altre. Volendo possiamo estenderla: se invece di due misure di vento ne abbiamo, che so, 24, possiamo comunque definire il vettore vento medio sommando le 24 componenti Est (Nord) e dividendo per 24. Invece di solo 2. E questa è la velocità media vettoriale. Bella. Interessante di suo. In pratica ci dice dove finirà il palloncino che lasciamo libero alla deriva nell’aria, preda delle variazioni erratiche di cui il vento si mostra sempre capace. Adesso, però, assumiamo un altro punto di vista. Abbiamo appena installato nel nostro giardino una turbina eolica. È di quelle belle, una Turbina Darrieus, che per prendere il vento non deve neanche ruotare attorno al suo asse verticale. In questo caso delle variazioni nella direzione del vento non ci importa nulla: ciò che desideriamo si limita a quanta energia riusciamo ad estrarre dal vento, e nient’altro. Questa energia è proporzionale al cubo della velocità del vento. Ma non la vettoriale che abbiamo definito sopra: come dicevo, non è la direzione ad interessarci, ma il modulo della velocità. Modulo che possiamo esprimere in ogni istante come RadiceQuadrata(vx1*vx1 + vy1*vy1), RadiceQuadrata(vx2*vx2 + vy2*vy2), … La media di tutti questi moduli è chiamata velocità scalare. E per ragioni matematiche molto brutali, la velocità vettoriale non può essere maggiore della scalare, nemmeno se tentiamo di piangere in aramaico usando il dialetto ugro-finnico che si è usato nella periferia Sud di Smolensk nell’Anno del Signore 357 (o 573, o 735 – non ricordo bene 😌). Cosa ci dicono le velocità vettoriale e scalare del vento? Certo, lo abbiamo già detto. La velocità vettoriale è parente di uno “spostamento” di una massa d’aria. Invece, la velocità scalare ci informa su quanta “energia” c’è dentro il vento. Ma prendiamole insieme. Se la velocità vettoriale è molto bassa, e invece la scalare alta, vuol dire che nel tempo considerato il vento si è fatto un giro intero, ed è tornato da noi come un boomerang. Magari, raccogliendo nel suo percorso schifezze varie, spore, ragnetti, eccetera eccetera. Invece, se la velocità vettoriale è risultata poco diversa dalla scalare (diciamo inferiore ma di poco), allora vuol dire che i singoli vettori vento che hanno contribuito alla media erano tutti più o meno orientati nella medesima direzione, il che è un modo un po’ farraginoso per dire che c’era “vento teso”. “Deviazione standard circolare” Abbiamo visto che la velocità vettoriale, e la velocità scalare, se prese insieme ci permettono di capire se nell’intervallo di tempo che abbiamo considerato il vento si è comportato come una specie di boomerang, oppure se ha continuato a spirare più o meno dalla stessa direzione. Interessante, vero? Ancora di più, se immaginiamo di prendere in considerazione un tempo di mediazione uguale ad un giorno. Così, magari, potremmo distinguere tra di loro i casi di vento dominati dalle brezze locali, piuttosto che invece dalla circolazione sinottica: nel primo caso (sto parlando da tipica sciura de Milan) possiamo aspettarci che il vento vada e venga, cambiando direzione nel corso delle ore. Nel secondo, invece, che la sua direzione sia più costante (di solito, qui a Milano, lungo l’asse Est-Ovest). Però mica possiamo tenere le due velocità separate: dobbiamo in qualche modo metterle insieme. Come, però? A questo fine ci viene in soccorso la “statistica circolare”, una disciplina relativamente non-giovane (🤭), ma poco conosciuta, che permette di fare previsioni e mettere in ordine dati di tipo direzionale, come appunto la direzione di provenienza del vento. E infatti, nella cassetta degli attrezzi della statistica circolare c’è una grandezza utilissima, espressa da una formalina semplice semplice: DSC = 1 – velocità vettoriale / velocità scalare Questa grandezza è chiamata deviazione standard circolare. Il suo valore è compreso fra zero (vento perfettamente teso, che spira sempre nella medesima direzione) e 1 (il vento fa uno o più “giri” completi, per tornare sempre indietro). I casi 0 e 1 sono perfettamente possibili. Classificare i giorni Bene. Abbiamo veduto come sia possibile calcolare la deviazione standard circolare: e allora facciamolo, usando i dati della stazione SHAKEUP di Cinisello Balsamo Parco Nord. Compresi tra il 7 Marzo ed il 16 Aprile del 2021 (va be’, mi piaceva quellal periodo lì). I dati in questione sono disponibili su base oraria, e riguardano la velocità e la direzione del vento rilevate a 10m dal suolo. Nulla vieta di aggregarli per giorno, e per ogni giorno calcolare la deviazione standard circolare. Parco Nord è nell’area urbana della Città di Milano (in un’enclave a parco pubblico), e così possiamo immaginare che almeno in alcune giornate la deviazione standard circolare sia molto alta – cioè che ci troviamo in

L’insostenibile leggerezza del ricircolo Leggi tutto »

Una "particella" in moto nell'atmosfera, trascinata alla deriva dal vento medio, e spostata dalle fluttuazioni turbolente

Modelli a particelle: basi prima delle basi

Patrizia Favaron Modelli a particelle? Di quanti modelli di dispersione esistano, e di una possibile classificazione, avevo già scritto… Avevamo visto, così, più o meno a cosa servono i modelli di dispersione, e come li si potrebbe classificare. E, forse, mi ero lasciata sfuggire una frase circa la grande efficacia e modernità dei “modelli a particelle”. Sì, ma che cosa sono? Come funzionano? E perché sono così “efficaci”? Ne vedremo, in un altro articolo. In questo, invece, vedremo alcuni aspetti “propedeutici” (🫣 mi scusate la parolaccia?) Ma prometto: saranno cose divertenti. E per parte mia farò il possibile per farmi perdonare d’essere una matematica: userò parole, e non formule… Un fatto, comunque, mi sembra piuttosto certo: gli famiglia di modelli porta con sé un linguaggio, un insieme di presupposti fisici o matematici (o tutti e due). Anche, una koiné di utenti affezionati, sviluppatori appassionati, investigatori acutissimi e geniali. Questo vale anche nel caso dei modelli a particelle, e nel loro caso il “linguaggio” ha molto il sapore dei processi casuali (qualcuno, qualcuna li chiama anche “processi stocastici“, ma che dire, le parole semplici mi piacciono di più – soprattutto a parità di significato). Camminate (deterministiche… 😇) nel continuo (Che belli, i giochi “Dai, facciamo finta che…” cui tanto tempo dedicavo da bambina… 😍 Mi piacevano proprio tanto, e, complici i miei due anni in più e la conseguente maggiore stazza, mi era facile reclutare il mio fratellino, che a dirla tutta non sembrava altrettanto interessato alla cosa. Probabilmente, però, nonostante i pochi anni passati sono ancora una bimba, perché i giochi facciamofintache restano ben presenti nella mia vita, e i processi casuali sono certamente tra questi.) (Ecco.) Facciamo finta di prendere un punto, vincolato ad una retta di lunghezza infinita. Facciamo anche finta che il punto si possa spostare lungo questa retta senza incontrare attriti. Ora, supponiamo che al tempo iniziale (che chiameremo “istante zero”) il nostro punto occupi la posizione iniziale di coordinata 0, che chiameremo “origine”. E qui comincia il bello. O, più esattamente, il ballo: all’istante 0, il punto ubico un primo spostamento, che lo porta nel punto di coordinata x1. Poi, al tempo t1, subisce un nuovo spostamento che lo porta nella posizione x2. Al tempo t2 ne subirà un terzo, che lo porterà in x3. E via così, sin che la noia non ci suggerisca di smettere. Come avvengono tutti questi spostamenti? In effetti non lo ho detto. In effetti potrebbero essere di ogni tipo. Per esempio, ogni spostamento potrebbe avere entità +1, e nel caso le posizioni successive {x0=0, x1, x2, …, xn} sono facilissime da prevedere: {0, 1, 2, …, n} Oppure, gli spostamenti potrebbero essere tutti uguali a -1. Od anche, lo spostamento all’istante i-esimo potrebbe essere uguale al doppio dello spostamento al passo precedente, con il primo spostamento uguale ad 1. Nel caso, per la cronaca la successione delle posizioni è {0, 1, 3, 7, 13, …} Successioni come queste sono puramente deterministiche: esiste una regola che, data una posizione, ci permette di prevedere esattamente la posizione successiva. E di più: questa regola, magari complicatissima, ammette come “dati di ingresso” soltanto la posizione al passaggio precedente, ed il numero del passaggio. Situazione, questa, piuttosto comune: tanto da meritarsi un nome, camminata (deterministica) nel continuo. Il fatto che una successione di posizioni (di punti sulla retta) sia deterministica non ne fa qualcosa di poco interessante – e difatti alcune successioni sono a dir poco famosissime: per esempio, quella formata dai Numeri di Fibonacci, {1, 1, 2, 3, 5, 8, …} în cui ogni elemento si ottiene come somma dei due che lo precedono. Possiamo scriverla come una “camminata nel continuo”, nel senso che ho detto? Sì, anche se a livello estetico la definizione in termini di “somma dei due valori che precedono” è molto più bella da vedere – comunque, vediamola lo stesso: F(n) = (1.61803…^n – 0.61803…^3) / 0.23606… dove 0.23606… è la radice quadrata di 5, 1.61803 la “sezione aurea”, cara ai pittori del Rinascimento, e 0.61803… la sua “coniugata” (i numeri di Fibonacci, e la storia delle loro apparizioni spesso misteriose nella Natura, sono protagonisti di un bellissimo libro, Livio M, 2017, La sezione aurea. Storia di un numero e di un mistero che dura da tremila anni, Biblioteca Universale Rizzoli). Quanto allo strano accento “^”, l’ho usato (in mancanza di meglio su questi schermi) per indicare l’elevamento a potenza intera: x^n = x * x * x * … * x (n volte). Insomma, già pescando tra le camminate deterministiche nel continuo si trova davvero di tutto, molto spesso interessante (ricordo, anche, e con affetto, il corso di Matematica combinatoria del geniale professor Michele Sce, intorno al 1986 a Matematica a Milano, in occasione del quale ci introdusse a numerosi altri “numeri magici” della Matematica, tra i quali i Numeri di Bernoulli cari ad Ada Lovelace, per dire solo un caso – ma sarebbero troppi, per parlarne qui. Anche perché le successioni deterministiche non sono state, che io sappia, molto usate per rappresentare i fenomeni di diffusione, e quindi la dispersione. Per arrivare a questi dobbiamo fare un passo piccolo piccolo, ma, come vedremo, dalle conseguenze (letteralmente!) esplosive. La Camminata a Caso nel Continuo Ecco: abbiamo introdotto le camminate deterministiche nel continuo, ed abbiamo veduto come le possiamo scrivere come Valore “adesso” = Valore “prima” + Spostamento “adesso” oppure Valore “adesso” = Regola “per adesso” Ora concentreremo l’attenzione sulla prima di queste due forme (che mi ricorda molto più da vicino il concetto di “camminata” come successione di passi). E già che ci siamo, introduciamo un poco di convenzioni per facilitare il racconto. Intanto, con “x(t)” intendiamo la posizione del punto all’istante “t” rispetto al sistema di coordinate che immaginiamo di imporre sulla retta (lineare). E adesso, l’ipotesi: x(t + dt) = x(t) + S dove con “dt” ho indicato un breve intervallo di tempo (non necessariamente infinitesimo!), e con “S” la novità: uno scostamento casuale, cioè, una variabile casuale di cui immaginiamo di conoscere la distribuzione

Modelli a particelle: basi prima delle basi Leggi tutto »

Modelli di dispersione Gaussiani: Alcune cose da sapere, e 3 miti da sfatare

Patrizia Favaron C’era una volta… Un certo numero di anni fa, i computer personali di oggi non esistevano. E nemmeno esistevano le calcolatrici programmabili. Al massimo, ma dico proprio al massimo e per fortuna, si disponeva di un regolo e di “tavole numeriche”. (C’ero anch’io, a quel tempo, ma non c’entro: ero letteralmente una bambina 😇.) In compenso, inquinavamo come oggi. Anzi, se possibile peggio. E c’era così già la necessità di prevedere le ricadute al suolo delle grandi emissioni (di solito, camini industriali). Così, già allora servivano modelli di dispersione che fossero abbastanza facili da poterli usare. La risposta furono i modelli di dispersione Gaussiani. Ricordo di averne veduto uno interamente cartaceo: un libro, con nomogrammi e regoli e tavole numeriche, che permetteva (con una faticaccia) di determinare la ricaduta al suolo in uno o pochi punti “recettori”. Oggi i modelli Gaussiani sono ormai quasi solo una curiosità storica, ma è davvero molto interessante vedere in che modo sono stati costruiti: secondo me, sono un esempio davvero meraviglioso di modello, nell’accezione di “semplificazione della realtà finalizzata ad ottenere risultati che qualcuno giudica utili”. Com’è fatto un “modello Gaussiano”? Quasi non c’è niente da dire: l’equazione del modello ci sta in poche righe! Davvero, con un poco di pazienza possiamo eseguirlo con una calcolatrice scientifica. I modelli di dispersione che sono arrivati in epoche storiche successive (statistici, euleriani, lagrangiani) richiedono tutti calcolatori più o meno potenti, a volte potentissimi: ma a quei tempi, non ci si poteva permettere altro. La domanda che sorge spontanea sui modelli Gaussiani è: ma come ci sono arrivati? La risposta è, trovo, affascinante. E credo sia interessantissimo, sul piano didattico, vedere “come si faceva” 😊. Come ci sono arrivati? Correvano, come dicevo, anni remoti. Ma non così remoti che a quei tempi non si conoscesse l’equazione di advezione-diffusione: Ma prima di procedere, credo sia doverosa una premessa: tutto quello che sto per dire è la versione semplificata, ma molto molto, del materiale che ho presentato ad un seminario a inizio 2024 ai Fisici e alle Fisiche di UNINSUBRIA. Il tono della mia presentazione voleva essere leggero, e spero di esserci riuscita, anche se riguardandola mi è venuta una certa voglia di fare dei cambi (non mi preoccupo più di tanto: è dal 1962 che convivo con me stessa, e lo so: va sempre a finire così). Nel caso, la trovate qui: Visto che le spieghe sono già tutte là, qui possiamo limitarci alle cose fondamentali., senza il pericolo di perderci nei passaggi. Se avrai la bontà di prendere visione della presentazione vedrai come il procedimento, piuttosto tortuoso, ha richiesto moltissimo ingegno, unito alla capacità di “fare i conti a mano” un tempo diffusa. Capacità e ingegno, però, da soli non bastano: per semplificare le equazioni bisogna fare delle ipotesi. Restrittive. E tanto più, quanto meno diffusa è la disponibilità di risorse di calcolo. Queste, e non altro, fanno (sempre) della scelta di un modello di dispersione un’assunzione di responsabilità molto precisa. In effetti i modelli di dispersione non sono esattamente la stessa cosa dei tubi Dalmine che ho visto usare per i teleriscaldamenti:non esistono tabelle, linee guida e norme che sostituiscano un senso critico da Fisici e Fisiche. “Per favore non usateli!”: un po’ di myth-busting a proposito di modelli Gaussiani La concentrazione prevista al suolo non è un valor medio La semplificazione dell’equazione di advezione-diffusione presume l’esistenza di una soluzione “stazionaria”, cioè che non cambia rispetto al tempo. Una volta che la si ottiene, però, è appunto stazionaria, e la cosa ha un peso enorme: vuol dire, in pratica, che il rilascio di cui ci interessa quantificare la ricaduta al suolo è avvenuto con le stesse modalità dall’eternità negativa sino all’ora corrente. In questa infinità di tempo, vento e turbolenza si suppongono rimasti esattamente uguali. E (altra ipotesi), dato che il tracciante non è reattivo, la sua massa si conserva: ma se ne è stata rilasciata una quantità ad un rateo costante finito per un’infinità di tempo, allora la massa totale è infinita? Se prendete l’equazione del modello Gaussiano e la integrate nelle tre dimensioni spaziali, vedete che in effetti l’integrale diverge. In Matematica questa non è una grande novità: esistono funzioni semplicissime, come ad esempio il reciproco, 1/x, il cui integrale da 0 a x tende ad infinito al crescere di x. Eppure 1/x, al crescere di x, tende a zero, e neanche troppo lentamente. E però, il fatto che in ogni “ora simulata” (che in realtà è una infinità di tempo dall’eternità negativa a quell’ora lì) troviamo una massa infinita suona, come minimo, allarmante: l’ipotesi non è realistica. E particolarmente in certi contesti geografici (la Pianura Padana per dirne uno). In certi, ma non in tutti: nelle Grandi Pianure americane, o nelle vaste aree pianeggianti dell’Asia Centrale, invece, le variazioni del vento e della turbolenza avvengono con molta calma più spesso che nel mio cortile di casa, e nel caso i modelli Gaussiani in certe situazioni funzionano meglio che da me. Per com’è definita, la concentrazione al suolo di un modello stazionario quindi non è un valor medio, ma una sorta di strano “valore limite” ipotizzando condizioni che si mantengono costanti per un tempo infinito. Una concentrazione-limite, per caso, sovrastima le concentrazioni vere? Dopotutto è “limite”, e il suo integrale è infinito. La risposta, però, in generale è negativa. In una situazione normalmente non-stazionaria, per esempio, il vento medio continua a cambiare direzione, e questo induce “avvolgimenti” nel pennacchio di tracciante rilasciato da un punto. Questo “avvolgersi” può comportare localmente il manifestarsi di concentrazioni più alte di quelle previste dai modelli Gaussiani. Che quindi non sono necessariamente “più conservativi”! Sono, se mai, approssimazioni più crude di quelle dei più recenti modelli Lagrangiani… Il modello Gaussiano restituisce concentrazioni infinite se la velocità del vento diventa zero Se guardiamo anche solo distrattamente l’equazione dei modelli Gaussiani vediamo subito che la velocità del vento vi compare a denominatore. Quindi è vero: se la velocità del vento diventa zero, allora la concentrazione prevista dal modello

Modelli di dispersione Gaussiani: Alcune cose da sapere, e 3 miti da sfatare Leggi tutto »

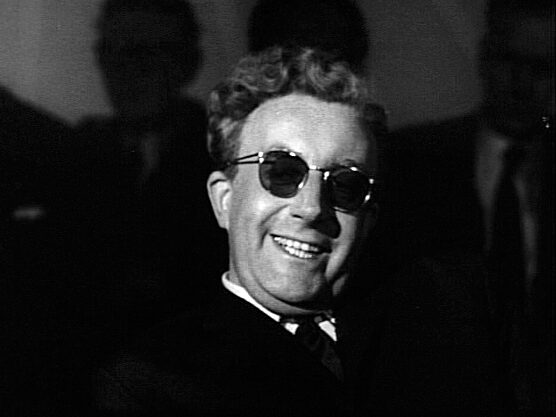
Peter Sellers nella veste del Dr. Stranamore, nel film omonimo di Stanley Kubrick (immagine di pubblico dominio)

Modelli di dispersione e analisi dei rischi

Patrizia Favaron Il Lato Oscuro delle ricadute al suolo 😊 I modelli di dispersione lagrangiani, come visto nell’articolo introduttivo sui modelli di dispersione, hanno la prerogativa di restituire ad ogni passo temporale un valor medio della concentrazione al suolo. Se invece che di un modello disponessimo però di un sensore, che immaginiamo infinitamente veloce e preciso/accurato, e registrassimo tutti i dati da lui prodotti in un tempo di mediazione, non troveremmo un valore costante. Infatti, le concentrazioni di sostanze chimiche non sono costanti nel tempo, ma anzi soggette a fluttuazioni turbolente a causa delle quali i valori misurati tenderanno a distribuirsi più o meno come vediamo nell’istogramma qui sotto. Questa figura è rappresentativa di una distribuzione lognormale, e spesso le concentrazioni misurate sono distribuite così (con parametri diversi). Se la nostra attenzione è dedicata agli effetti a lungo termine dell’esposizione alle concentrazioni, questo livello di conoscenza in più non ci dice nulla di utile. Ma non tutte le sostanze disperse in atmosfera hanno effetti “a lungo termine”: alcune si rivelano nocive già in un singolo ciclo di inspirazione-espirazione (circa 10 secondi). Un esempio classico di questo tipo di effetti è quello degli agenti nervini, usati in alcune operazioni belliche e attacchi terroristici (un caso famigerato e famoso fu il rilascio di SARIN nei vagoni della metropolitana di Tokyo del 20 Marzo 1992). Nel caso degli effetti a breve termine, così, ad interessare non sono più i valori medi, ma le probabilità di supero di una concentrazione al di là della quale gli effetti si fanno pericolosi. E il confronto non è più con un limite di legge espresso in forma di statistica annuale, ma con l’entità complessiva degli effetti avversi. Il concetto di “rischio” Già: cosa si intende per “rischio”? Nel linguaggio comune, i “rischi” sono eventualità possibili e spiacevoli. Li si può evitare, oppure (qualcuno lo fa) cercare apposta. Ma questa non è una definizione: un’opinione, forse, e nulla più. Nella scienza, le opinioni contano meno del due di briscola neozelandese, per cui dobbiamo cercare qualcosa di meglio. Una vita professionale fa, quando mi occupavo di “sistemi programmabili per applicazioni safety critica” (e, assicuro, i “sistemi programmabili” di allora – prima metà degli anni ’90 – non inducevano ad una grande tranquillità) mi ero imbattuta in questa formula: Rischio di un evento = Magnitudine degli effetti avversi * Probabilità di occorrenza in un anno Nei casi che seguivo io, la “Magnitudine degli effetti avversi” si misurava in morti (già uno era da considerare un valore “alto”). Immaginiamo di seguire questa medesima impostazione, molto cruda – ne esistono, comunque, altre (ci sono, per esempio, i rischi finanziari, o politici, o…). Ora: torniamo alla nostra ricaduta al suolo. E supponiamo di conoscere esattamente la sostanza implicata (è un privilegio a volte raro: in certi incidenti industriali a priori non lo sai, e qualcuno deve avvicinarsi a prelevare dei campioni…). Al momento della ricaduta al suolo, la sostanza sarà caratterizzata da una certa concentrazione: la cosa prevista dal modello di dispersione! Bene: se la sostanza è conosciuta, allora è anche nota la concentrazione “di fuga” (possibilissimo che oggi sia conosciuta con un nome diverso), cioè, la concentrazione alla quale, se ti ci trovi esposta, hai mezz’ora per lasciare la zona. Il concetto, molto crudo, era che se per caso la concentrazione risultava maggiore di quel limite, le tue possibilità di fuga, e quindi di sopravvivenza, calavano velocemente a zero. Se chiamiamo “Cmax” questa concentrazione, e il modello di dispersione ci permettesse di stimare la sua probabilità ora per ora, allora potremmo determinare il rischio, che nel caso vorrebbe dire la frazione di persone che non riuscirebbero a sottrarsi. Problema: ma i modelli di dispersione permettono? C’è modello e modello… 🤔 Metto subito le mani avanti: i modelli che conosco e anche uso, per esempio Calpuff, non permettono. Dirò anzi di più: nella precedente puntata di questa serie (se l’avete mancata potete trovarla qui) avevo detto della classificazione dei modelli. E avevo accennato al caso dei modelli “stazionari”, un tempo usatissimi, ed oggi in via di estinzione (grazie anche al fatto che la US-EPA ormai raccomanda di non usarli). Bene: i modelli stazionari restituiscono un “valore limite” (nel senso matematico del termine: limite per t tendente ad infinito di…), che non è neanche un valor medio. Roba così non è di nessun aiuto, anzi, potrebbe essere persino fuorviante. Con i modelli lagrangiani parrebbe di poter dire che andiamo un po’ meglio: loro il valor medio orario della concentrazione ce lo danno. E però, ti rendi conto anche tu, manca un pezzo per completare il quadro: la deviazione standard lognormale. Certo, se l’avessimo potremmo calcolare la probabilità di supero della soglia di fuga, noti valor medio e deviazione standard lognormale. Ma appunto, non c’è… Entra in scena un nuovo attore Siamo nel 1990, epoca della Prima Guerra del Golfo (me la ricordo bene…). Ai tempi, sull’Iraq “regnava” Saddam Hussein, che aveva appena invaso il Kuwait. Va be’, la storia la potete trovare in rete. Quanto ai nostri casi, Saddam Hussein era famoso per usare la popolazione civile come scudo umano, e per ammassare stock ingenti di armi chimiche. Le due cose non andavano benissimo insieme: la coalizione ONU guidata dagli USA desiderava mettere le mani su quegli stock, o almeno renderli inoffensivi, ma farlo avrebbe significato esporre la popolazione civile a rischi (appunto) ingenti. Tali che, in caso di incidente, magari l’ONU avrebbe ritirato il mandato. La tecnologia militare di allora prevedeva dei “bombardamenti intelligenti” che, però, gli operativi in campo lo sanno bene, proprio intelligenti e chirurgici non sono. Ma soprattutto, metti di riuscire a centrare con un “bombardamento chirurgico” un complesso di produzione di SARIN che, guarda caso, era stato collocato a qualche centinaio di metri da un villaggio: se il vento tira dalla parte sbagliata, magari l’impianto lo distruggi anche, ma rischi di inondare di SARIN migliaia di persone innocenti e del tutto ignare del pericolo. Così (questa, almeno, la storia ufficiale) la CIA (sì, quella, la Central Intelligence Agency

Modelli di dispersione e analisi dei rischi Leggi tutto »

La derivazione di dettaglio delle “Reynolds-Averaged Navier-Stokes equations” (RANS): utile, magari, ma anche fonte di una sorpresa

Sui libri di testo di micro-meteorologia, di solito verso l’inizio, si dice che le “Reynolds Averaged Navier-Stokes equazioni” sono, uno, il pane della materia, e due, “con semplici passaggi si dimostra che…”.

Salvo che poi, per ragioni di spazio, nessuno quei facili passaggi ha il tempo di farli.

In questo articolo troverete il modo di scaricare una nota di laboratorio in cui presento i passaggi per esteso: opera molto interessante didatticamente e non solo, perché… perché…

No: non ve lo dico qui: non voglio privarvi della gioia della scoperta di una cosa davvero _molto_ interessante. 😊

La derivazione di dettaglio delle “Reynolds-Averaged Navier-Stokes equations” (RANS): utile, magari, ma anche fonte di una sorpresa Leggi tutto »